はじめに
OpenAI と Anthropic 以外のモデルは一切使わない主義だった。だが Devin が提供する無料の GLM-5.2 が、中国製モデルに対する私の印象を完全に塗り替えた。
GLM-5.2 は問題を見つけるのが速く、スクリプトや小さなツールを素早く量産するのに向いている。実環境で何度も試行錯誤を繰り返すのにも最適だ(たとえば webOS 内部のコマンドを検証させて、すぐに skill を作らせる、など)。一番とんでもなかったのは、Promo 期間中はいくら使っても枠を消費しなかったこと。コスパが異常に高かった。
使う量が増えた分、注目も増えたのだろう。7〜8月頃、X で中国製モデルの投稿をよく見かけるようになった。DeepSeek V4 Flash、V4.1 Flash、GLM-5.3 Flash という名前が特に多かった。言っていることはどれも似たようなものだ。ベンチマークスコアは第一陣、速い、token 単価が安い、画像入力にも対応。
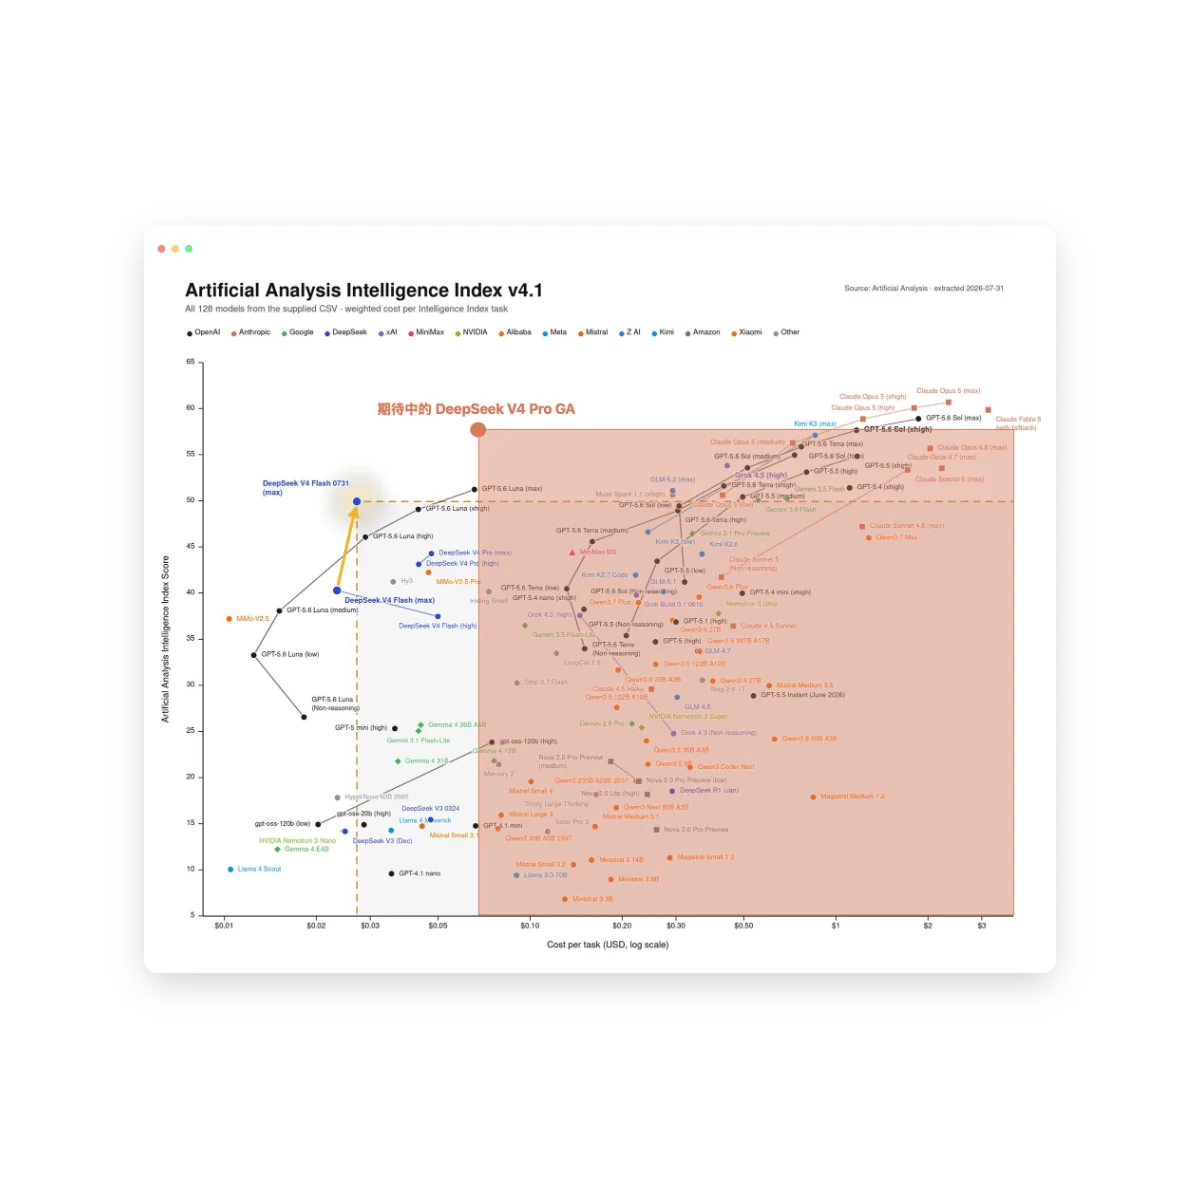
例えば DeepSeek V4 Flash 0731 を絶賛するこのポストは、話題の「キルゾーン」という言葉まで使い、図も「腰が抜けるほど凄い」風に作り込まれていて、それなりに説得力があった。
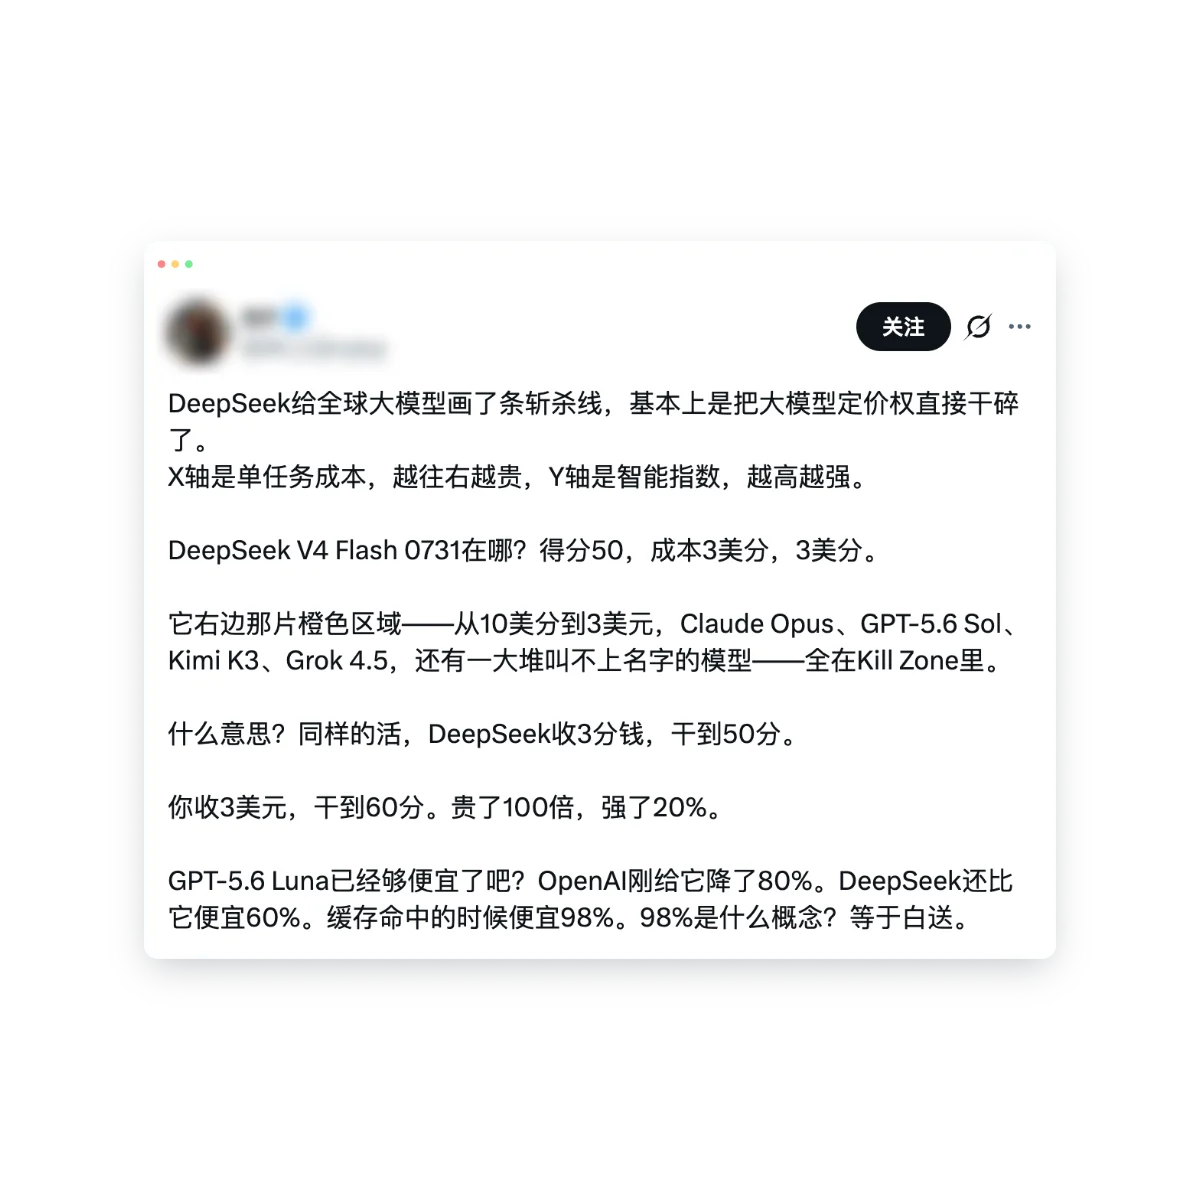
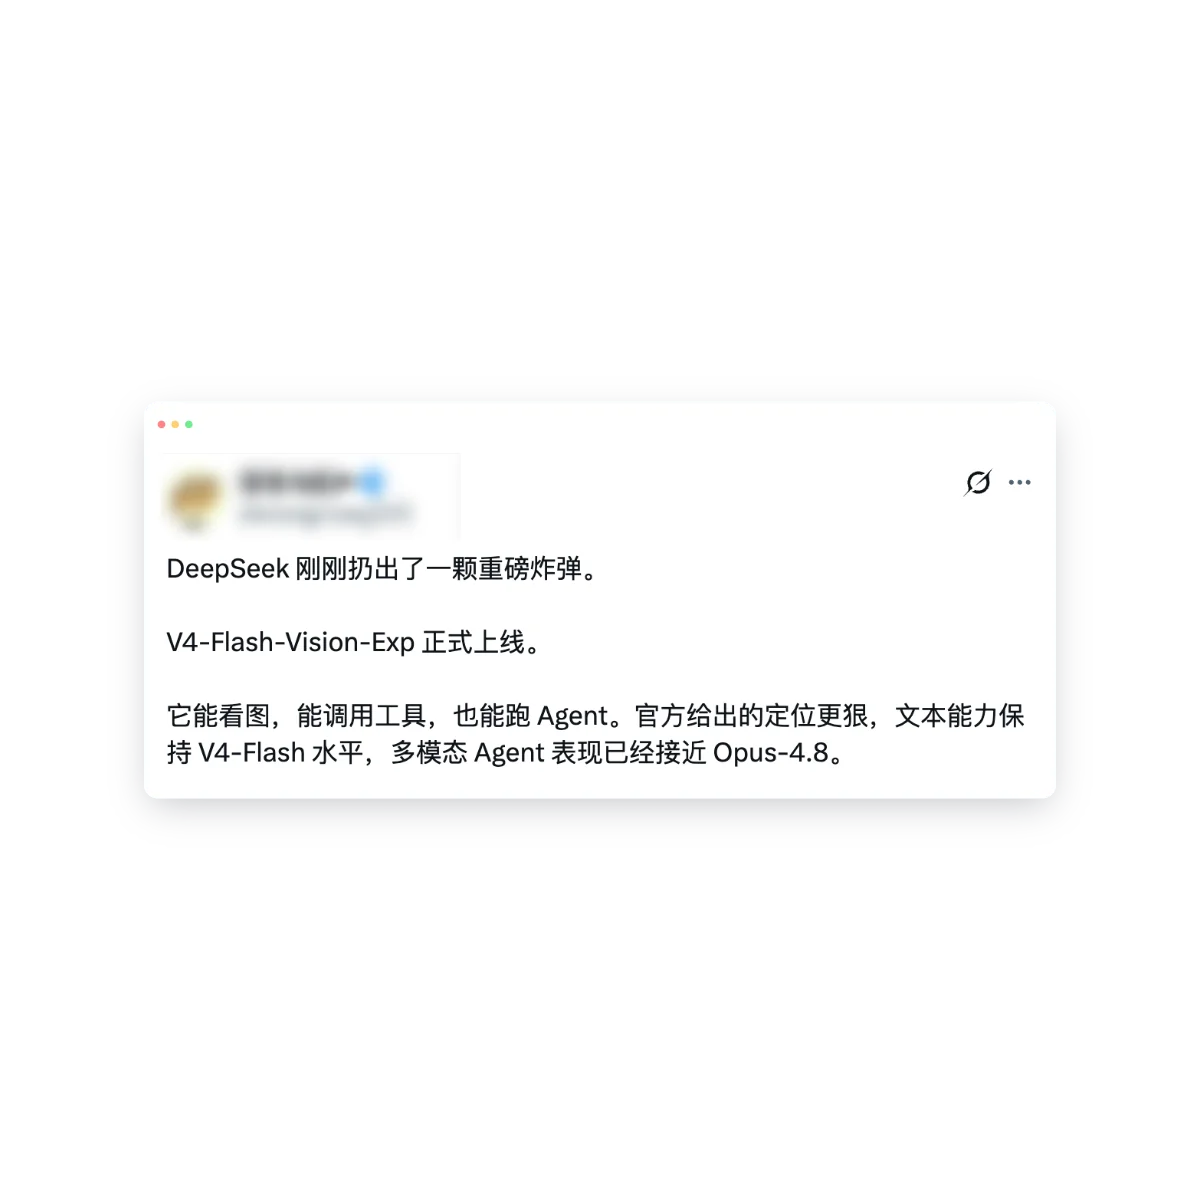
8月下旬、V4-Flash-Vision-Exp が公開された。宣伝によると、画像が読めて、ツールを呼べて、Agent も走る。マルチモーダル Agent の性能は Opus-4.8 に迫るとか。V4.1 Flash が出ると、「自分でスクリーンショットを撮り、画像を読み、UI を直せる」「本当に 5.6 Sol xhigh レベルの体験」という声も上がった。
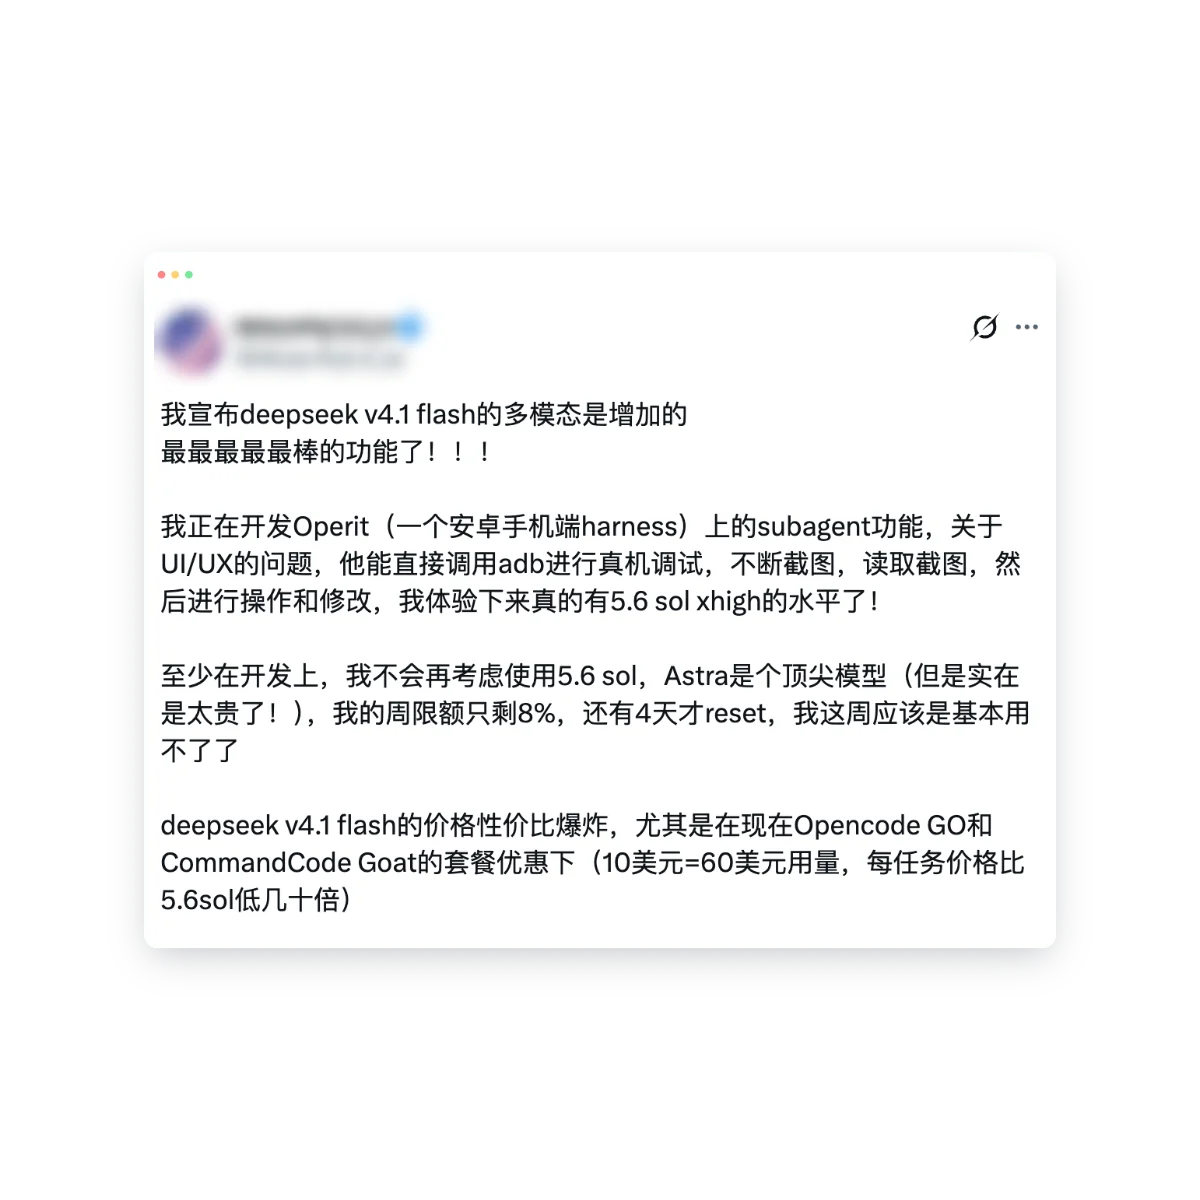
最もよく聞かれたのはやはり速度だ。「Flash は 3 分で 70 点を取れる。3 回イテレーションすれば 95 点も狙える。高級モデルが 15 分かけても 90 点止まりかもしれない」と言う人もいれば、「Astra が 80 点の解を出すのに十数分かかる間に、V4.1 Flash なら何往復も修正して 90 点まで持っていける」と言う人もいた。
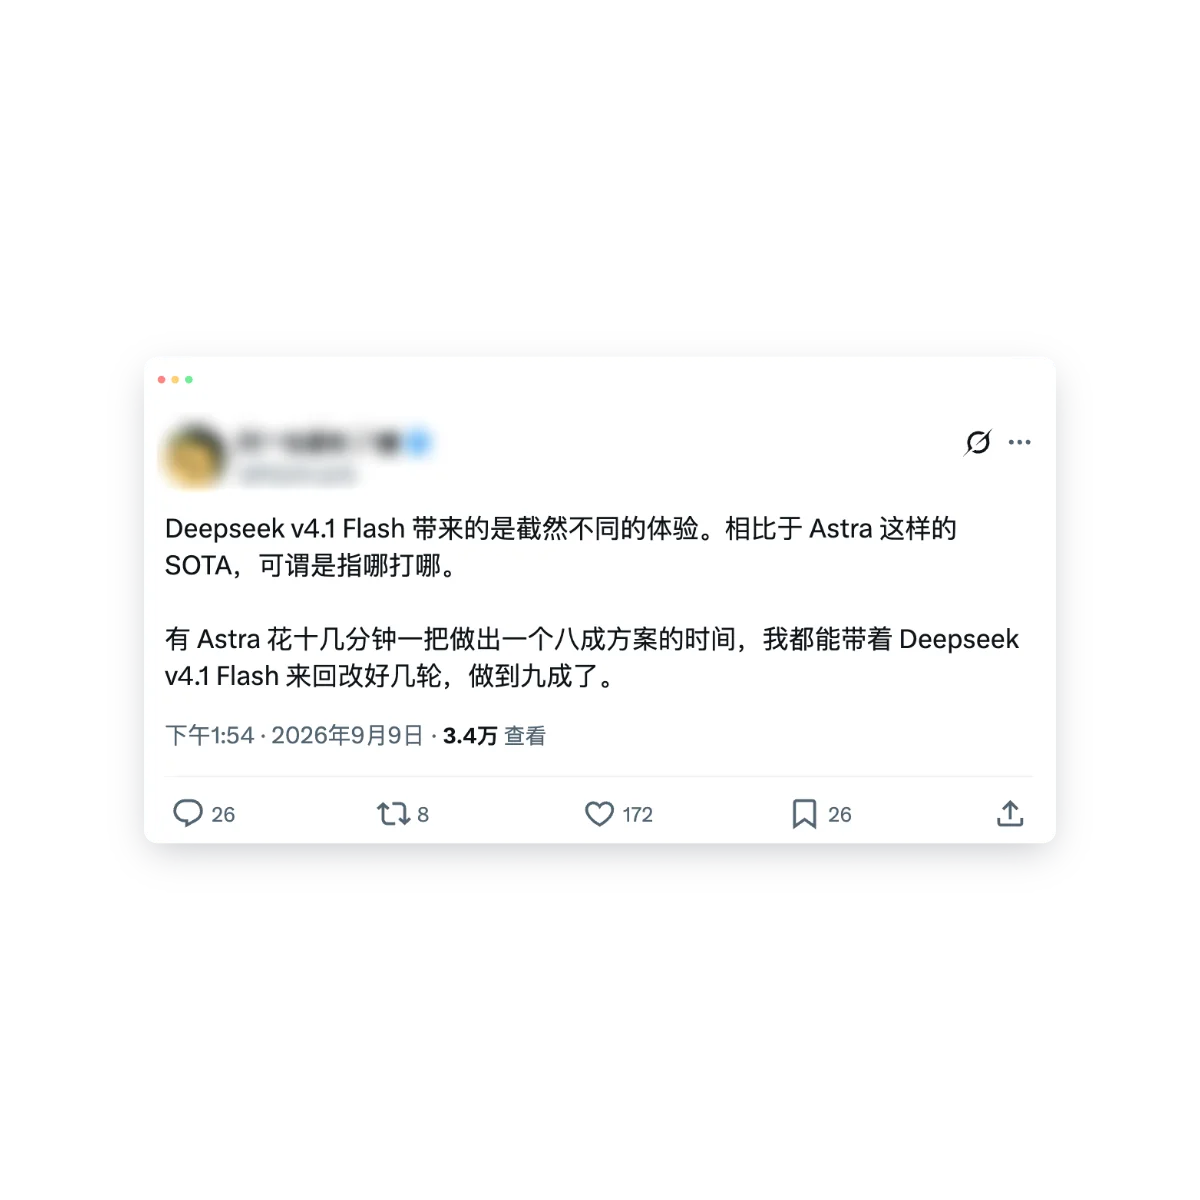
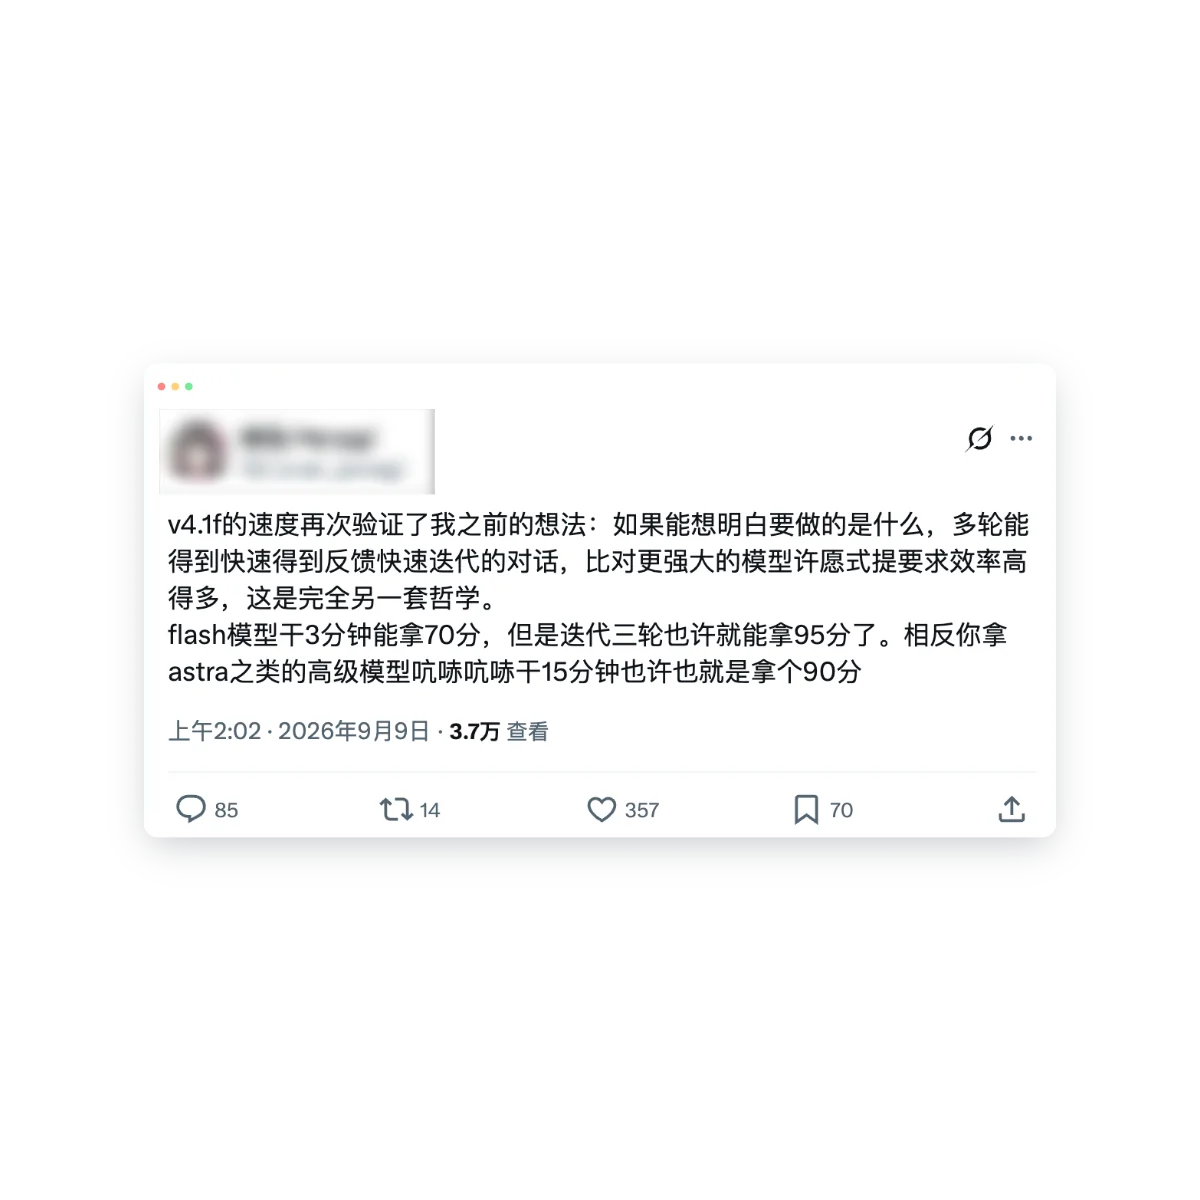
速いという話自体は信じていた。GLM-5.2 は実際とても速い。Opus がまだコードを読んでいる間に、GLM-5.2 はもうレビュー結果を返してくることも珍しくない。後継モデルが遅くなる道理もない。それに画像を読める点は私にとって実用的だった。フロントエンドの UI 問題は、言葉で説明したりエラーログを貼ったりするより、画面を直接見られるモデルの方がずっと楽だ。そこで OpenCode と Devin に新モデルが来たタイミングで、デフォルトモデルを切り替えた。ところが結果は、大きな失望だった……
何にハマったか
まず画像読み取り。
Pi Coding Agent で deepseek-v4-flash-vision-exp を使い、webOS アプリの UI 問題を調査していた。モデル自身に TV のスクリーンショットを撮らせた。
5 枚目を貼ったところで、API が 400 を返してきた:
1At most 4 image(s) may be provided in one prompt最初は意味が分からなかった。毎回 1 枚しか送っていないのに、なぜエラーになるのか。Pi をアップグレードしても解決しない。Opus で同じ実験をしてやっと分かった。Agent は毎回のリクエストに会話履歴全体を載せる。以前貼った画像もその中に含まれる。累計が 4 枚を超えると拒否されるのだ。モデル API の側で直接拒否されるため、以降のリクエストはすべて stopReason=error になった。その session は事実上使い物にならなくなった。
画像読み取りの上限の問題だ。API が 4 枚しか読めないのに、画像認識能力を大々的に売りにするのは、誇大広告と言うほかない。
仕方なく AGENTS.md で読み取り枚数を制限した。結果として、何の問題もない他のモデルまで同じ画像予算の上限を守る羽目になった。
次に、これらのモデルがやたら長時間走ることに気づいた。小さな問題、小さな要望でも、30 分かかる。
最終的には harness が reasoning に設けた上限にぶつかり、Pi や Devin に強制終了される。thinking を展開すると、大量の推論があった。細かい点に執拗にこだわっている。この傾向は 2 つの Flash モデルで最も顕著だった。考えるのは速いし、たくさん考える。だが同じ問題を解くのに、常に数倍の時間を要した。
「考えすぎないで」で解決できるか
最初は自分を疑った。Prompt の書き方が悪くて、「簡潔に」と伝えていなかったのか?タスクが大きすぎて、複雑なロジックの中を堂々巡りしているのか?
要望を小さく分割して簡単なタスクを与えると、少し長く考えても上限には達しなかった。だが何往復かしてタスクが中盤に入ると、やはり上限に達する。上限に達した session は事実上続行不能だ。
Prompt で直接指示したらどうか?例えば:
- 「思考の深さが制限を超えないように」
- 「考えすぎないで」
完全に無駄だった。harness の上限まで考え続けて終了する。この問題は Prompt で最適化できるものではない。
なぜ LLM は overthinking するのか?GPT に頼んで、同じ問題に遭遇した人、あるいは解決を試みている人がいないか、ネットを調べてもらった。
Overthinking はすでに研究課題だった
調べてみると、これはあなたの体感だけの話ではない。Overthinking はすでに LLM 推論研究における独立した問題になっている。
ここで言う overthinking は、回答が長すぎる・冗長という意味ではない。モデルがすでに十分な情報を持ち、実行可能な解を見つけ、正解にさえ到達したあとで、なお reasoning compute を投入し続ける状態を指す。研究者が関心を持つのは、「モデルは推論リソースをどこに使っているのか」「なぜ適切なタイミングで止まらないのか」だ。
Google DeepMind の TRACE はまさにこれを分析している。reasoning token の総量を数えるだけでなく、推論過程を sub-thought に分解し、各ステップでモデルがなぜ続行を選ぶのかを観察する。典型的な軌跡が 2 つある:
-
Explorer(過剰な探索)
実行可能な解がすでにあるのに、モデルは別ルートを探し続ける:
1実行可能な解をすでに持っている
2→ 別の可能性はないか?
3→ 2つ目を検証
4→ 3つ目の可能性を発見
5→ 探索を続ける
探索空間は十分なのに、モデルはそれを拡大し続ける。「まだ考えられる」を「考える価値がある」と取り違えている。
-
Late Landing(なかなか着地しない)
モデルは早い段階で正解に近づき、あるいは正解に達しているのに、検証を繰り返して終わろうとしない:
1答えが出た
2→ もう一度確認
3→ エッジケースを1つチェック
4→ 前の仮定を疑う
5→ 再検証
6→ さらに確認
これは over-verification に相当する。答えに到達した時点は早いのに、停止した時点はずっと遅い。
reasoning の限界収益に注目する研究もある。reasoning token を増やしても正確率が比例して上がる保証はない。最初は正の収益、やがてゼロに近づき、最後は負の収益になることがある:
1追加 reasoning の限界収益
2正の収益 → ほぼゼロ → 負の収益
すでに正しく答えていたモデルが、推論を続けた末に正解を疑い始め、間違った答えに書き換えてしまうことさえある。これは negative marginal reasoning utility と呼べる。
だから 3 つのことを区別する必要がある:
1問題を解く能力
2≠ どれだけ推論に投資すべきか判断する能力
3≠ 十分な時点で停止する能力
モデルが賢くても、reasoning の配分が苦手で、止まるのが苦手ということは十分あり得る。ベンチマークは通常「最終的に正解したか」だけを見る。しかし Agent の harness は、使った token 数、かかった時間、呼び出したツール数、そして予算内に終えられたかも気にしなければならない。
「考えすぎないで」が必ずしも効かない理由だが、自然言語の instruction はモデルの「続けるか止めるか」の傾向を変えられるだけで、決定論的なリソース制御装置ではないからだ:
1Prompt:「考えすぎないで」
2    ↓
3続行 / 停止の確率を変える
4    ↓
5一応確認 → もう一つの可能性 → もう一度チェック → …
6    ↓
7harness のハードリミット
8    ↓
9強制停止
Prompt は soft constraint であり、reasoning_tokens >= limit → terminate こそが hard constraint だ。モデルが「あまり考えない」を理解しても、それで信頼できる停止機構を獲得するわけではない。
ここまで読んで、真っ先に浮かんだのは Late Landing だった。2 つの Flash モデルは、しばしば「手がかりがない」のではなく、確認→覆す→再確認を繰り返した末に harness の上限にぶつかっていた。表面的には、着地条件を満たしているのに、ずっと停止の決定を下していないように見える。
これで、あの 2 行の prompt がなぜ効かなかったかも説明できる。「考えすぎないで」は確かに reasoning の長さに影響を与え得る。だが影響できることと、保証できることは別だ。いつ止めるかがモデル内部で学習された挙動である以上、数行の自然言語だけで厳密なリソース上限に変えるのは難しい。
Flash という名前も誤解を招きやすい。それは推論レイテンシ、スループット、価格を指す言葉であって、reasoning trajectory が短いことを保証しない。毎秒の生成が速いことと、総生成量が多いことは両立し得る。ゆっくり考えているのではなく、速いまま考えすぎているのだ。
そこで私は仮説を立てた。問題は「このタスクにどれだけ reasoning を投資する価値があるか、いつ止めるべきか」の判断にあるのではないか、と。2 つの Flash モデルが似た現象を示したことで、モデルはより積極的に探索し自己修正することを学んだのに、同じ割合で「適切に切り上げる」ことは学んでいないのではないか、と疑った。
だがこれはまだ仮説にすぎない。実際にどれだけ考えたのか、どこで止まれなくなったのか、GLM-5.2 とどれくらい違うのか?これらの Agent は session ログをローカルに残している。その痕跡をどう分析し、定量化すればいいのか?
Overthinking の痕跡を定量化する
session ログ
Pi と Devin はどちらも session をローカルに保存する。GLM-5.2 にスクリプトを書かせ、ログから reasoning 内容を抽出し、モデル別に集計した。
まず、どのログが読めるか:
| ソース | ログパス | フォーマットとフィールド | reasoning は読めるか |
|---|---|---|---|
| Pi | ~/.pi/agent/sessions/**/*.jsonl |
JSONL、content[].type === "thinking" |
読める |
| Devin | ~/.local/share/devin/cli/transcripts/*.json |
JSON、steps[].reasoning_content |
読める(session 終了後に書き込まれる) |
| Copilot | ~/.copilot/session-state/*/events.jsonl |
JSONL、data.reasoningText |
読める |
| Codex | ~/.codex/sessions/**/*.jsonl |
JSONL | 読めない(暗号化) |
| Grok | ~/.grok/sessions/**/chat_history.jsonl |
JSONL | 読めない(フィールドが空) |
Codex と Grok は除外した。
thinking block を含む session のみを集計対象とした。
私の使用感をもとにグループ分けし、サンプル数が少なすぎるモデルは除外した:
| グループ | モデル | Session 数 |
|---|---|---|
| ✅正常(計 153) | GLM-5.2 High | 68 |
| GPT-5.6 Sol | 56 | |
| GPT-5.6 Luna | 29 | |
| ❓問題あり(計 85) | DeepSeek V4 Flash | 40 |
| GLM-5.3 Flash | 33 | |
| DeepSeek V4.1 Flash | 12 | |
| 🗑️サンプル不足・対象外(計 9) | Gemini 3.8 Flash | 3 |
| GPT-5.6 Terra | 2 | |
| Claude Opus 5 | 1 | |
| Qwen 3.7 Max | 1 | |
| ox-alpha-free | 1 | |
| GPT-5.4 | 1 |
thinking block の文字数
同じ high effort の条件で、まず各モデルが平均どれだけ考えたかを見る:
| モデル | Session 数 | 平均最大ブロック(文字) | 平均総思考文字数 | 平均ブロック数 |
|---|---|---|---|---|
| GPT-5.6 Sol | 56 | 513 | 4,418 | 25.0 |
| GPT-5.6 Luna | 29 | 1,362 | 11,440 | 79.6 |
| GLM-5.2 High | 68 | 7,117 | 35,510 | 26.4 |
| DeepSeek V4 Flash | 40 | 14,844 | 167,479 | 70.0 |
| GLM-5.3 Flash | 33 | 18,927 | 123,280 | 56.6 |
| DeepSeek V4.1 Flash | 12 | 29,795 | 221,134 | 67.1 |
GPT-5.6 Luna の平均最大ブロックは 1,362 文字。DeepSeek V4.1 Flash は 29,795。22 倍の差だ。
GLM-5.2 は中間に位置する。GPT-5.6 より多く、Flash より一段少ない。
超過率
「超過」の判定ラインを次のように定めた。session が以下のいずれかを満たせばカウントする:
- 12,000 文字を超える thinking block が 1 つでもある
- thinking block の累計が 80 個以上
- 累計思考文字数が 100,000 以上
| モデル | Session 数 | 超過数 | 超過率 |
|---|---|---|---|
| GPT-5.6 Sol | 56 | 2 | 4% |
| GPT-5.6 Luna | 29 | 3 | 10% |
| GLM-5.2 High | 68 | 11 | 16% |
| GLM-5.3 Flash | 33 | 20 | 61% |
| DeepSeek V4 Flash | 40 | 25 | 62% |
| DeepSeek V4.1 Flash | 12 | 10 | 83% |
正常グループは 4〜16%、3 つの Flash は 61〜83%。中間は空白だ。同じ GLM でも、5.2 の 16% から 5.3 Flash の 61% へ、およそ 4 倍になっている。
これは私の使用感と一致する。ただ超過率が示すのは「よく考えすぎる」ことだけだ。具体的にどう考えすぎるのか?
データの限界
- Devin では DeepSeek V4 / V4.1 Flash は最低でも high しか選べず、low と medium は検証できない。
- すべて実使用の session であり、モデルごとにタスクの難易度が異なる。累計系の閾値は、長時間の正常 session に誤検出を起こし得る。
Overthinking の 2 つの典型形態
Overthinking は 2 つの形態に整理できる:
1形態 1: 縦に深掘り(単ブロック 10k〜80k 文字。推論と否定を繰り返す)
2形態 2: 横に展開(単ブロックは普通に見えるが、ほぼ毎回ツール呼び出しの前に考え、総量が積み上がる)
1. 縦に深掘り(単ブロックの異常な膨張)
モデルが 1 つの thinking block の中で数万文字に及ぶ独り言に陥る。仮説を立てては覆し、境界条件を論証し直す。
典型的な症状:
- 正常なモデルの単ブロックは通常数百文字で、ツール呼び出しの前提条件を整理する程度。
- 問題のあるモデルは 1 ブロックで平気で 20,000〜70,000 文字を出力し、単純な関数名の変更を月面着陸プロジェクトのように推論する。
実際のケース(GLM-5.3 Flash):
2 つの問題を調べさせた。早送り時にプログレスバーが震える問題と、早送り倍率が効かない問題だ。adb での長押しシミュレーションがなかなか分からなかったので、3 分間に 3 通のメッセージを連投した:
112:46:57  まだ長押しの方法が分かっていないなら、前に DS4.1 がやったやり方を読んで
212:48:26  session 履歴を直接読んで。同じテーマの pi session があるから
312:49:54  session の冒頭は「2つの問題をチェック 1 再生画面で早送りプログレスバーが震える……」
「DS4.1」とは、以前 DeepSeek V4.1 Flash で走らせた同テーマの session のことだ。それを読み漁った末、session 全体で最大の thinking block を書き出した。59,740 文字。そのブロックの中で、「DS4.1」を次々とこう推測していった:
- DualShock 4 コントローラー。
.1はファームウェアバージョンかもしれない - design spec 4.1
- AGENTS.md のルール 4.1 条
0.5.1またはPS4.1の誤記
途中で私に直接聞こうかとも考えた:
Actually, let me just ask… no wait
ブロックの終わりになっても、まだコントローラーを研究していた:
OR!!! Wait. DS4 as gamepad: D-pad on gamepads is often an AXIS (HAT_X/HAT_Y), not keys! …… OK, enough.
この session は合計 44 個の thinking block、累計 247,665 文字だった。最終的に私が自分で検証し、巻き戻しが早送りに化けていることを発見。その部分は revert させ、数字が震える問題の修正だけを残した。
2. 横に展開(毎ステップ考え、総量が爆発)
この形態はより分かりにくい。各 thinking block を個別に見ると、数百〜2、3千文字と「控えめ」に見える。だがツール呼び出しの前にほぼ毎回 1 つ書き込むため、ブロック数が増えると累計思考量がとんでもないことになる。
実際のケース(DS V4.1 Flash):
同じ session で、2 つの要望を立て続けに出した:
| 要望 | thinking ブロック | 累計文字数 | ブロックあたり平均 | 最大ブロック | ツール呼び出し | 所要時間 |
|---|---|---|---|---|---|---|
| 最近の再生履歴をクリアできる設定を追加 | 44 | 42,984 | 977 | 8,415 | 85 | 約 6 分 |
| 設定ページを 2 カラムから 1 カラムに整理 | 39 | 71,666 | 1,837 | 9,430 | 63 | 約 13 分 |
2 つの要望で計 83 ブロック、114,650 文字、148 回のツール呼び出し。12,000 文字の critical 閾値に触れたブロックは 1 つもない。単ブロックだけを見ていては捕まえられない。2 つ目の要望は 2 カラムを 1 カラムに変えるだけなのに、累計思考量は先ほどの 59,740 文字の単ブロックより長い。
ブロックを開いてみると、大半はごく小さなことを考えている:
- 2,701 文字:クリアボタンの横に「最近の再生 N 件」と出すか、plurals リソースを使うか、ついでに RTL まで考慮
- 1,363 文字:1 カラム化で削除できる import を 1 つずつ列挙
- 786 文字:
\bremember\bでrememberが 3 箇所ヒットしたのを確認し、その 3 箇所がどれかを推論 - 648 文字:リポジトリで
HorizontalDividerを使った例がなく、現行バージョンにあるか不明なので、高さ 1dp のBoxを区切り線にする判断 - 214 文字:
Oops! I accidentally replaced the material icons imports...— 前のステップで壊した import の修正
どの 1 段落も単体では妥当に見える。問題は、毎ステップこういう文章を書くことだ。
同じ high でも、意味は違う
overthinking に遭遇したとき、最も直接的な対処は reasoning effort を下げることだ。だが 4 社の公式ドキュメントで effort の定義を並べてみると、同じ high でも指しているものがまったく違う:
| 選択可能な段 | デフォルト | ドキュメントの説明 | |
|---|---|---|---|
| OpenAI | none minimal low medium high xhigh max(モデルによる) |
medium |
high は難しい推論・複雑なデバッグ・深い計画向け。モデルは各段内で適応し、簡単なタスクではより少ない token を使う |
| Claude | low medium high xhigh max |
多くのモデルで high |
high はタスクが必要とするだけ token を使う。effort は行動シグナルであって厳密な token 予算ではない |
| DeepSeek | 実質 low high max のみ |
high |
medium を要求すると high にマップされる。xhigh も high にマップされる |
| GLM | low high max |
max |
low は軽量推論、high は強化推論、max は深い推論 |
ドキュメントから直接読み取れることは 2 つある:
- 目盛りが違う。 OpenAI は 7 段で
highは中より上。DeepSeek と GLM は 3 段でhighが真ん中の段だ。harness のドロップダウンで同じhighでも、裏側の目盛りは異なる。 - 「タスクの難易度に応じて伸縮する」と定義に書いているのは OpenAI と Claude だけ。 DeepSeek と GLM のドキュメントは深さ(軽量・強化・深い)の説明だけで、同様の記述は見当たらなかった。
以下は私の推測だ:
effort がハードな予算でない以上、high が実際にどれだけ考えるかは訓練で学んだ挙動と考えるしかない。訓練時にモデルは各段階で大まかな長さの分布を学ぶ。ドキュメントの書きぶりから見て、OpenAI と Claude は少なくとも「同じ段階でも、簡単なタスクは少なめに、難しいタスクは多めに考える」を訓練目標にしている。Flash モデルは「段が高いほど深く考える」という 1 次元だけを学び、タスク難易度に敏感でないのかもしれない。だからごく小さな問題でも深い推論の長さで走る。これが縦の深掘りだ。これは前の仮説とも整合する。問題は「このタスクにどれだけ reasoning を投じる価値があるか」の判断にある。
横の展開は interleaved thinking と関係しているかもしれない。GLM のドキュメントには interleaved thinking がデフォルトで有効と明記されており、モデルはツール呼び出しの合間ごとに考える。「このステップは簡単だから考えなくていい」と学んでいなければ、ツール呼び出しのたびに固定の「思考税」を納めることになる。先のケースでは、ほぼ毎回のツール呼び出しの前に thinking block があった。まさにその姿だ。
さらに Flash のポジショニングがある。もともと大量の呼び出しを速く安く回すための軽量モデルだったのに、今や深い推論側の目盛りに置かれている。
Overthinking が起きたら教えてくれないか?
問題がモデル自体にあるなら、根本的な解決策は 2 つしかない。モデルを変えるか、reasoning effort を下げるかだ。
困るのは、下げられないことが多いことだ:
- Devin では、DeepSeek V4 / V4.1 Flash は最低でも high しか選べない
- GLM-5.3 は公式に
thinking.type: "disabled"を廃止し、thinking は常時オン。最低は low。デフォルトはreasoning_effort: "max"。公式ベンチマークでは、max 段はタスクあたり平均約 75K output tokens - DeepSeek の thinking モードでは
temperature、presence_penalty、frequency_penaltyがすべて無効になる - OpenCode にも、DeepSeek V4 の thinking を切るボタンがほしいという issue がある
私が「おかしい」と気づく頃には、だいたいすでに harness 上限に達していて session は死んでいる。欲しかったのは、上限に達する前に「この session はもう正常ではない」と教えてくれるものだ。
まず Pi コミュニティの既存プラグインを探した:
| プラグイン | 検出対象 | overthinking を捕まえられない理由 |
|---|---|---|
pi-loop-police |
thinking block 内の連続した重複(80 文字以上) | ハマりループを検出するもの。また MAX_WINDOW が 4,000 しかなく、4,000 文字超のブロックはそもそも見ない |
pi-deadloop |
連続 4 回の応答で Jaccard 類似度 85% 以上 | これもループ検出 |
pi-behavior-monitors |
別の LLM で行動を分類 | ルールベースではなく、判定ごとにもう 1 回モデルを呼ぶ |
pi-thinking-tail |
長い thinking block を折りたたみ表示 | 表示だけ。検出も通知もしない |
どれも「問題=繰り返し」を前提にしている。だが Flash の overthinking は繰り返さない。どのブロックも新しい内容で、ただ長すぎる・多すぎるのだ。
上のデータ分布を見ると、正常グループと問題グループはきれいに離れている。指標で Overthinking の発生を判定できるはずだ。
Next Action:通知ツール pi-overthink-warning を作る
目標は明確だ。モデルの overthinking を代わりに解決するのではなく、現在の session が過去の正常分布から明らかに逸脱したかを判定して、私に知らせる。
単ブロックの閾値
- 正常モデルの session の平均最大ブロックは 3,936 文字、問題モデルは 19,045。4.8 倍差
- 正常モデルの thinking block は p95 が 2,608 文字、p99 が 6,672
閾値はこの位置に置いた:
| レベル | 閾値 | 意味 |
|---|---|---|
| warn | 5,000 文字 | 正常モデルの p95(2,608)超 |
| alert | 8,000 文字 | 正常モデルの p99(6,672)超 |
| critical | 12,000 文字 | overthinking 確定 |
5,000 文字では正常ブロックの 1.56% しか発火しない。約 64 個に 1 つだ。12,000 では 0.37%。誤判定の確率は十分低い。
累計閾値
2 つ目の形態への対応:
- 正常モデルは session あたり平均 25〜35 ブロック、5k〜35k 文字
- 問題モデルは session あたり平均 58〜88 ブロック、129k〜281k 文字
| レベル | ブロック数 | 総文字数 |
|---|---|---|
| warn | 50 以上 | または 50,000 以上 |
| alert | 80 以上 | または 100,000 以上 |
50 ブロック / 50k 文字は正常モデルの上限、80 ブロック / 100k 文字はすでに問題モデルの領域だ。どちらかの指標がラインに達したら通知する。長時間の正常 session もこの量に達し得るので、累計側は warn と alert のみで critical は設けない。
プラグイン化
いくつかの原則:
- 通知のみ、介入しない。会話に prompt を挟まず、reasoning を改変せず、モデルも中断しない。
- ブロッキングしない。ポップアップなし。warn は黄色通知、alert は黄色通知、critical は赤通知。
- 昇格のみ、降格なし。session 内で最高レベルを記録し、ツール呼び出しごとに出し直さない。
- 文面はまず “Switch model”、次に “lower reasoning effort if available”。モデル切替を先に置くのは、そもそも下げられないモデルが多いからだ。
例えば単ブロックが critical に達すると、通知はこうなる:
1Thinking block {n} chars. Over 12000 confirmed overthinking.
2Switch model now or lower reasoning effort if available.
Devin ではまだリアルタイム通知できない。Devin の hook は PreToolUse、PostToolUse、UserPromptSubmit、Stop、SessionStart、SessionEnd、PostCompaction だけで、reasoning 関連のイベントがない。reasoning 内容は session 終了時に transcript に書き込まれるため、実行中には読めない。
インストールと再現
リポジトリはこちら:https://github.com/CheerChen/pi-overthink-warning
インストール:
1pi install https://github.com/CheerChen/pi-overthink-warning分析スクリプトも同じリポジトリにある:
 1git clone https://github.com/cheerchen/pi-overthink-warning
 2cd pi-overthink-warning
 3
 4# 全 session を一括スキャンし、モデル別に集計
 5uv run scripts/batch_scan.py
 6
 7# モデルをマージして超過率を計算
 8uv run scripts/incident_rate.py
 9
10# 単一 session の特徴抽出
11uv run scripts/analyze_overthinking.py "label" /path/to/session.jsonl
プラグインの限界
- 繰り返すが、このプラグインは通知するだけで、モデルの overthinking を止めはしない。
- モデルごとにタスク難易度が異なる。正常使用の session でも誤検出があり得る。
最後に
ここまでで Flash モデルへの理解はいくらか深まった。だが実際に振り回された時間と労力も払った。
この一連の作業でひどく疲れた。結果を定量化するのが疲れたのではない。これだけ多くの実タスクが、モデルの欠陥による Overthinking の犠牲になっていたと知って疲れたのだ。中国の大規模モデルには、まだ長い道のりがあるのは明らかだ。速さと安さだけを追い求めて品質が伴わなければ、実用にどんな意味があるのか。
そして煽ることしか能がないインプレ稼ぎアカウント。インプレッションを稼ぐ前に、自分で手を動かして実際に使ってから発言してはどうか。いつもいきなり「腰が抜けるほど凄い」「特大爆弾」「キルゾーン」だ。こうした無責任な話術と、二度と振り返らない通りすがりにばかり届けるプラットフォームの配信が相まって、デジタル時代の発言は次々と「同類項の整理」にされ、ひたすら耳目を集めるだけの荒唐無稽な営みと化している。
参考
- Do LLMs Really Need 10+ Thoughts for “Find the Time 1000 Days Later”? Towards Structural Understanding of LLM Overthinking
- Do NOT Think That Much for 2+3=? On the Overthinking of o1-Like LLMs
- Inverse Scaling in Test-Time Compute
- Thinking Mode | DeepSeek API Docs
- GLM-5.3 - Z.AI Developer Document
- [FEATURE]:Deepseek-V4 need a “disable thinking” button · anomalyco/opencode#24610
 CheerChen です。