前言
我原本是一概不用 OA 两家之外的模型的。但是 Devin 提供的免费 GLM-5.2 刷新了我对国产大模型的印象。
GLM-5.2 找问题速度快,非常适合快速产出脚本和小工具,在实际环境能反复尝试进行快速试错(比如让它验证 webos 底层的命令,能快速产出 skill),最离谱的是在 Promo 期间用多少都不计入额度,性价比超高。
可能是用得多了,关注也多了。7~8 月份的时候,我经常能在 X 上刷到国产大模型的帖子。DeepSeek V4 Flash、V4.1 Flash、GLM-5.3 Flash 这几个名字出现得特别多。说法都差不多:benchmark 分数进了第一梯队,跑得快,token 单价便宜,还支持图片输入。
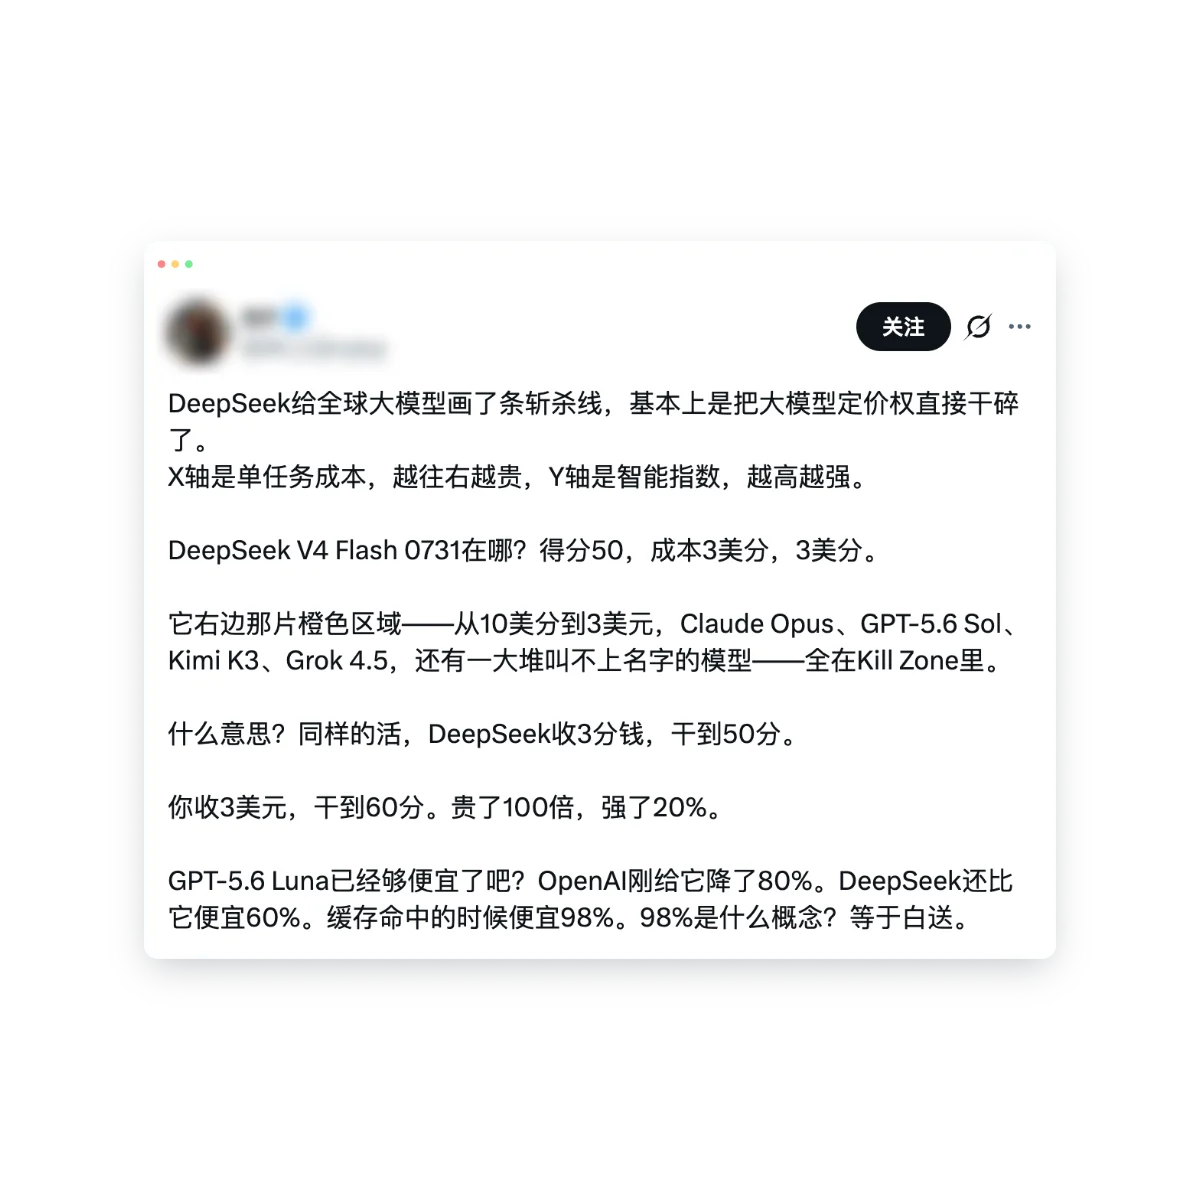
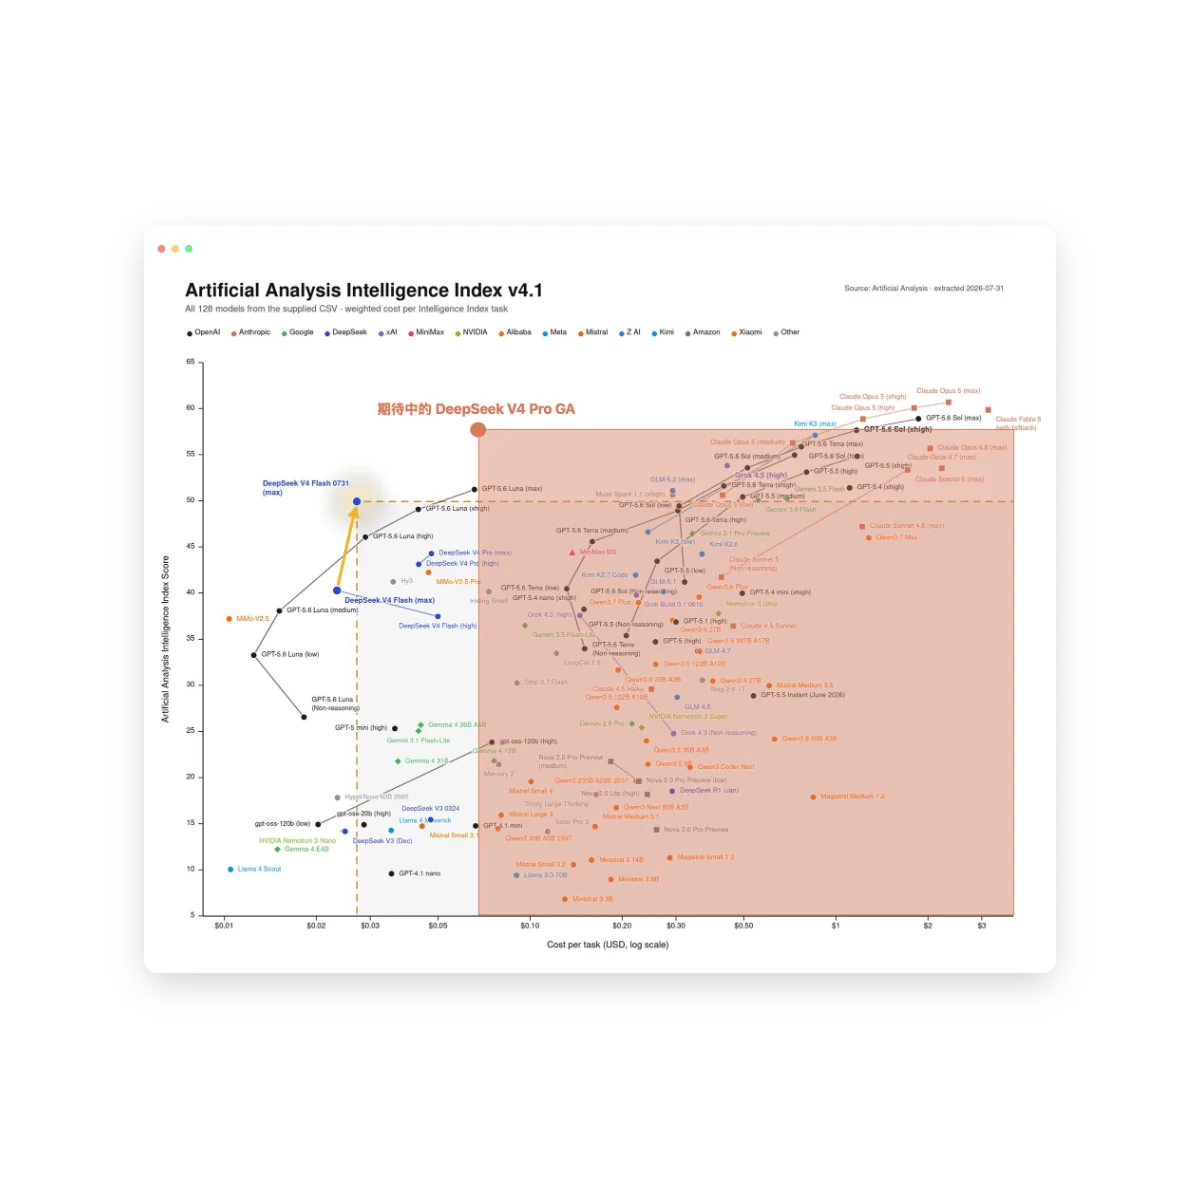
比如这个帖子狂吹 DeepSeek V4 Flash 0731,还带上了“斩杀线”这个热门词,图也做得令人“瘫坐惊呼”,挺像那么一回事的。
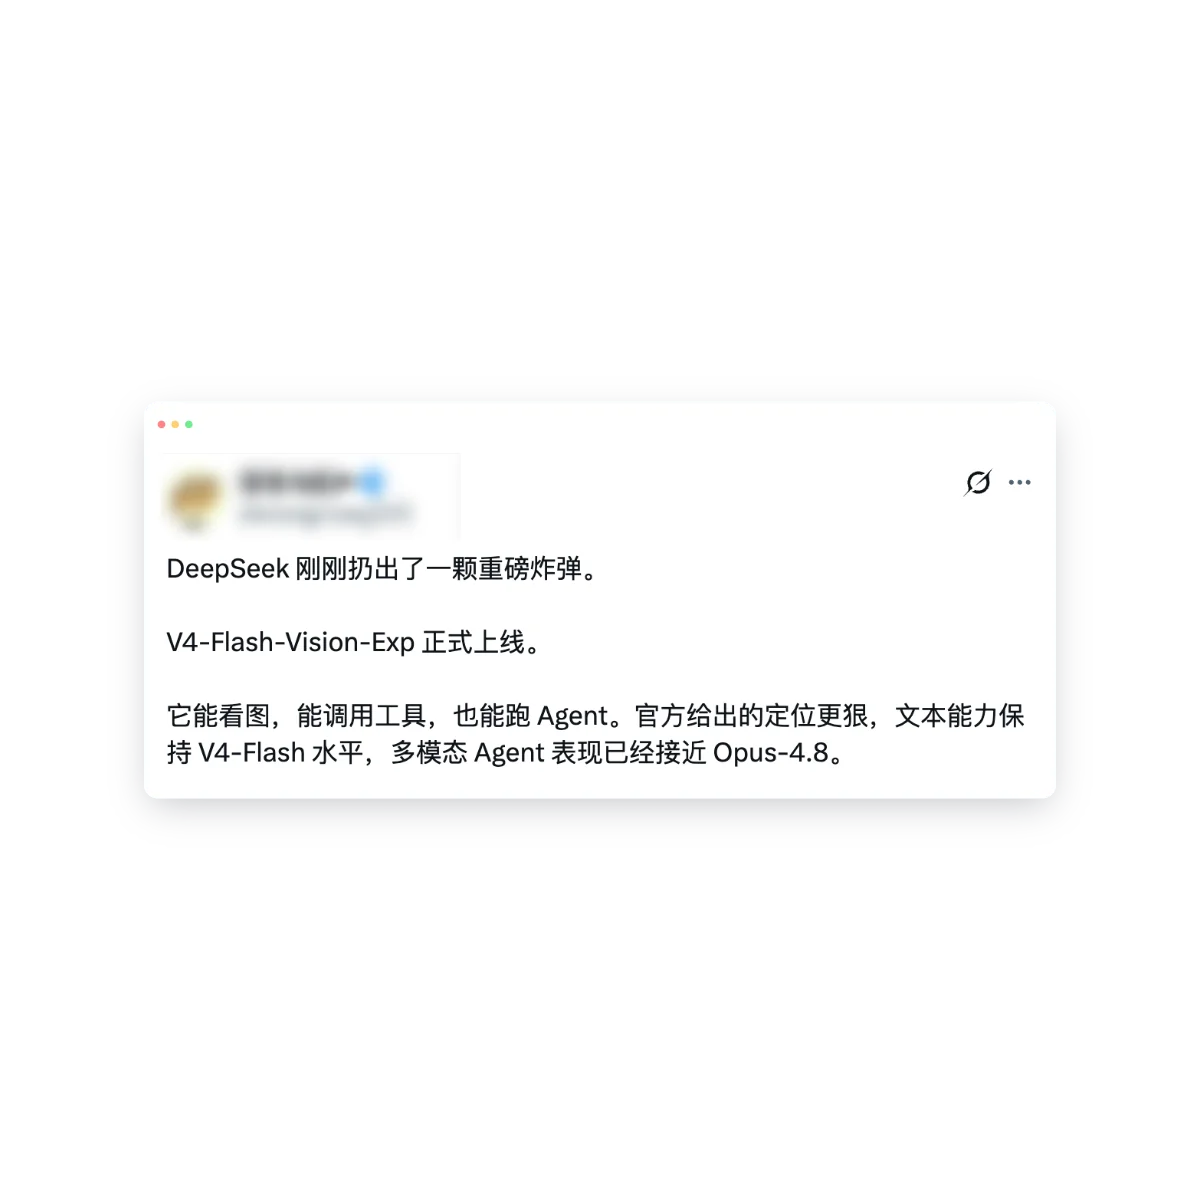
到了 8 月下旬,V4-Flash-Vision-Exp 上线,宣传里说它能看图、能调工具、能跑 Agent,多模态 Agent 表现接近 Opus-4.8。V4.1 Flash 出来以后,又有人说它能自己截图、读图、改 UI,体验“真的有 5.6 sol xhigh 的水平”。
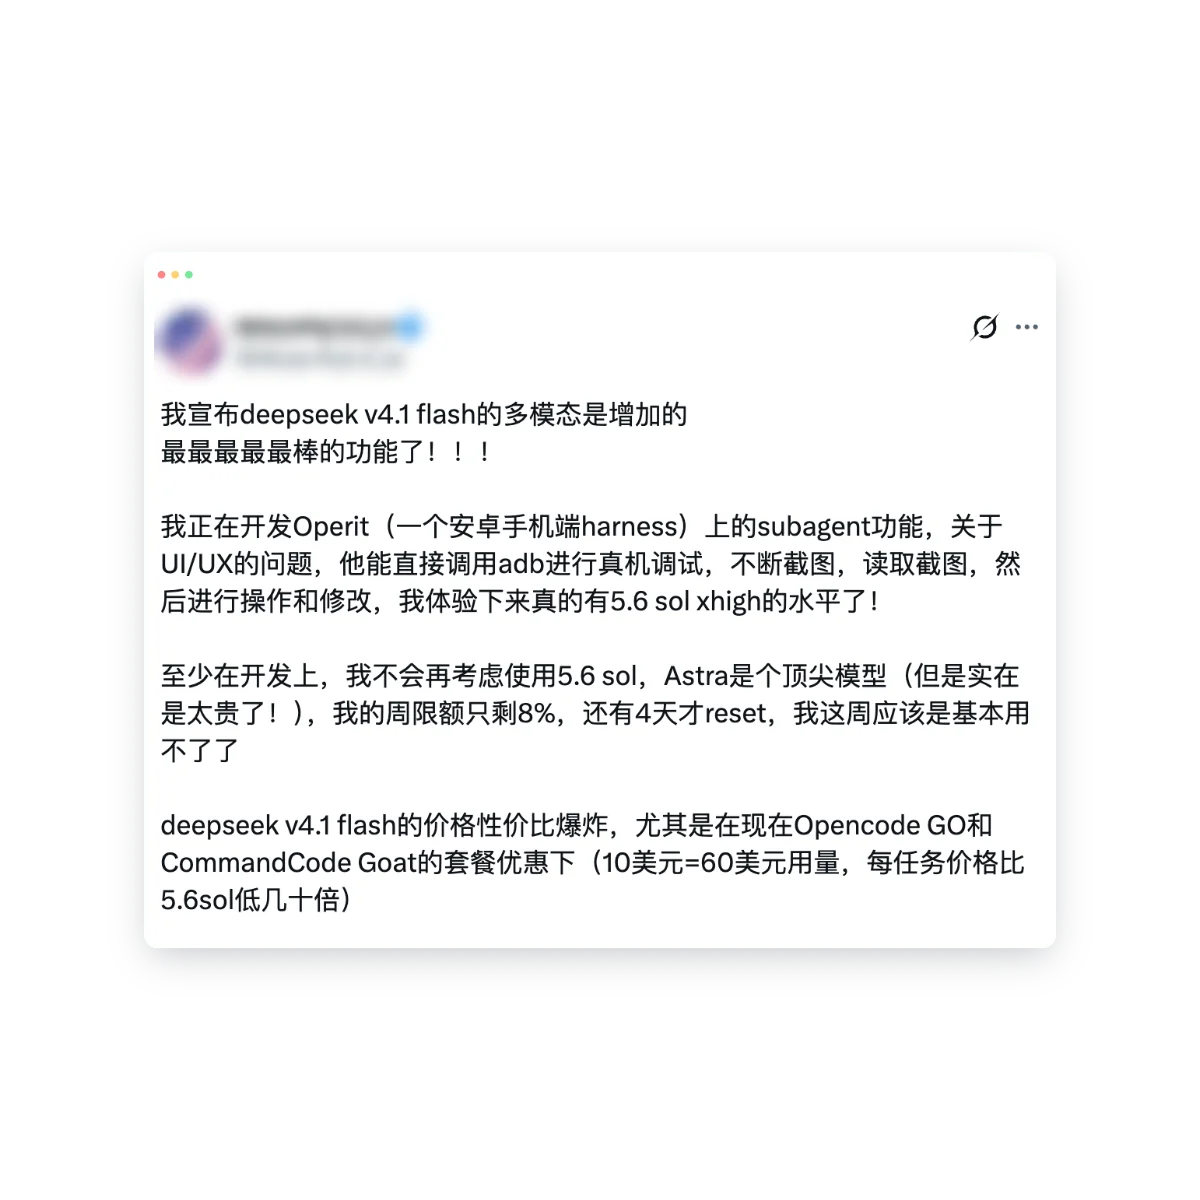
说得最多的还是速度。有人说 Flash 干 3 分钟能拿 70 分,迭代三轮也许就能拿 95 分,高级模型吭哧吭哧干 15 分钟也许只拿 90 分。也有人说,Astra 花十几分钟做出八成方案的时间,带着 V4.1 Flash 已经能来回改好几轮,做到九成。
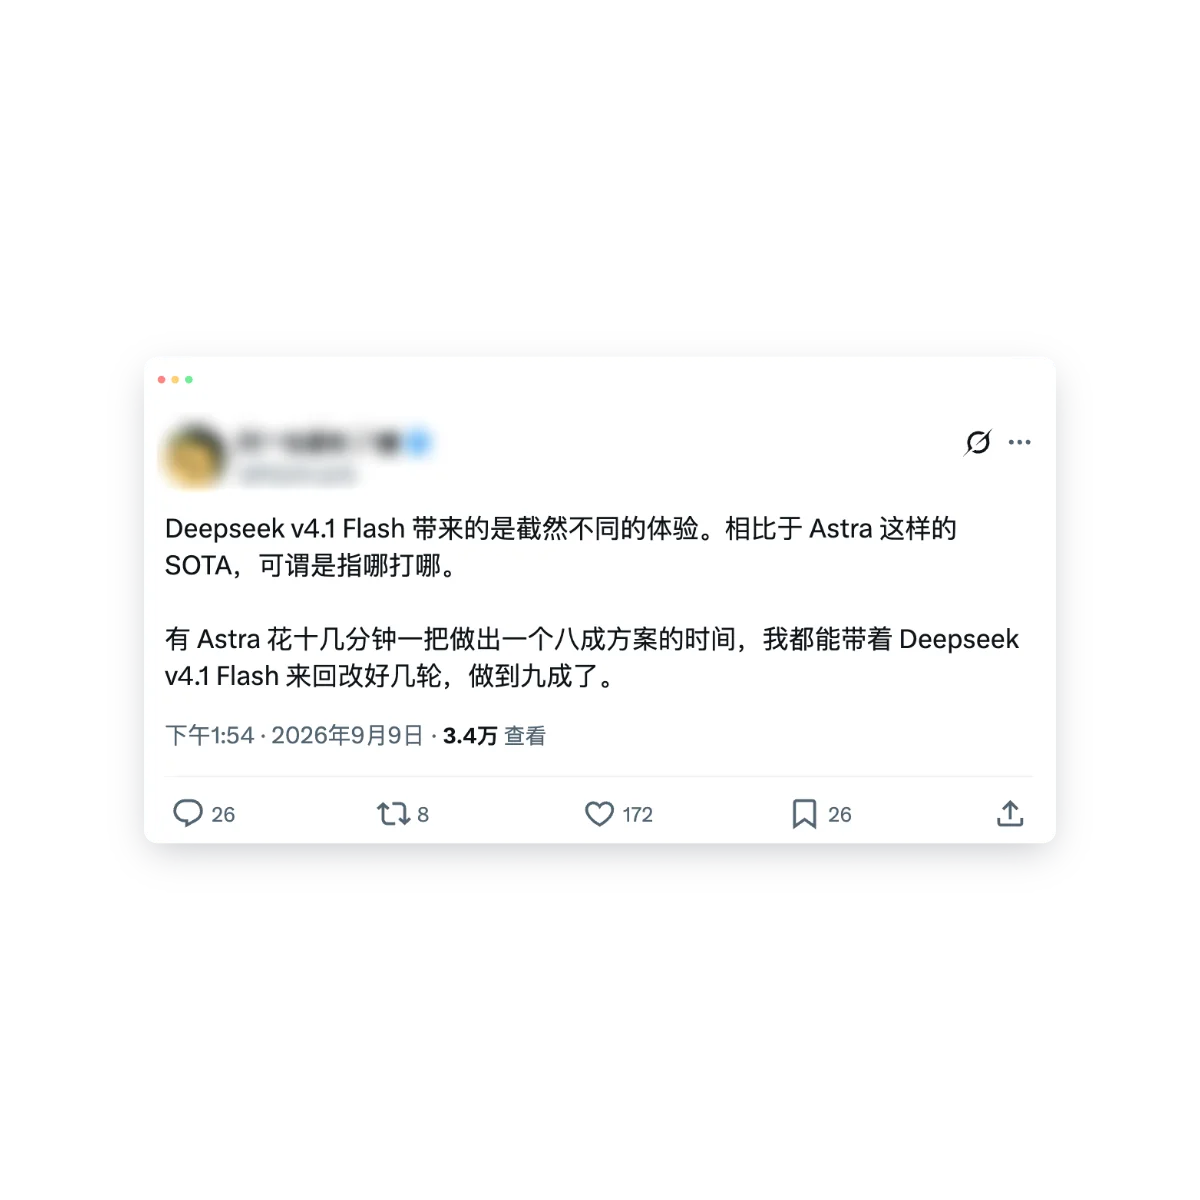
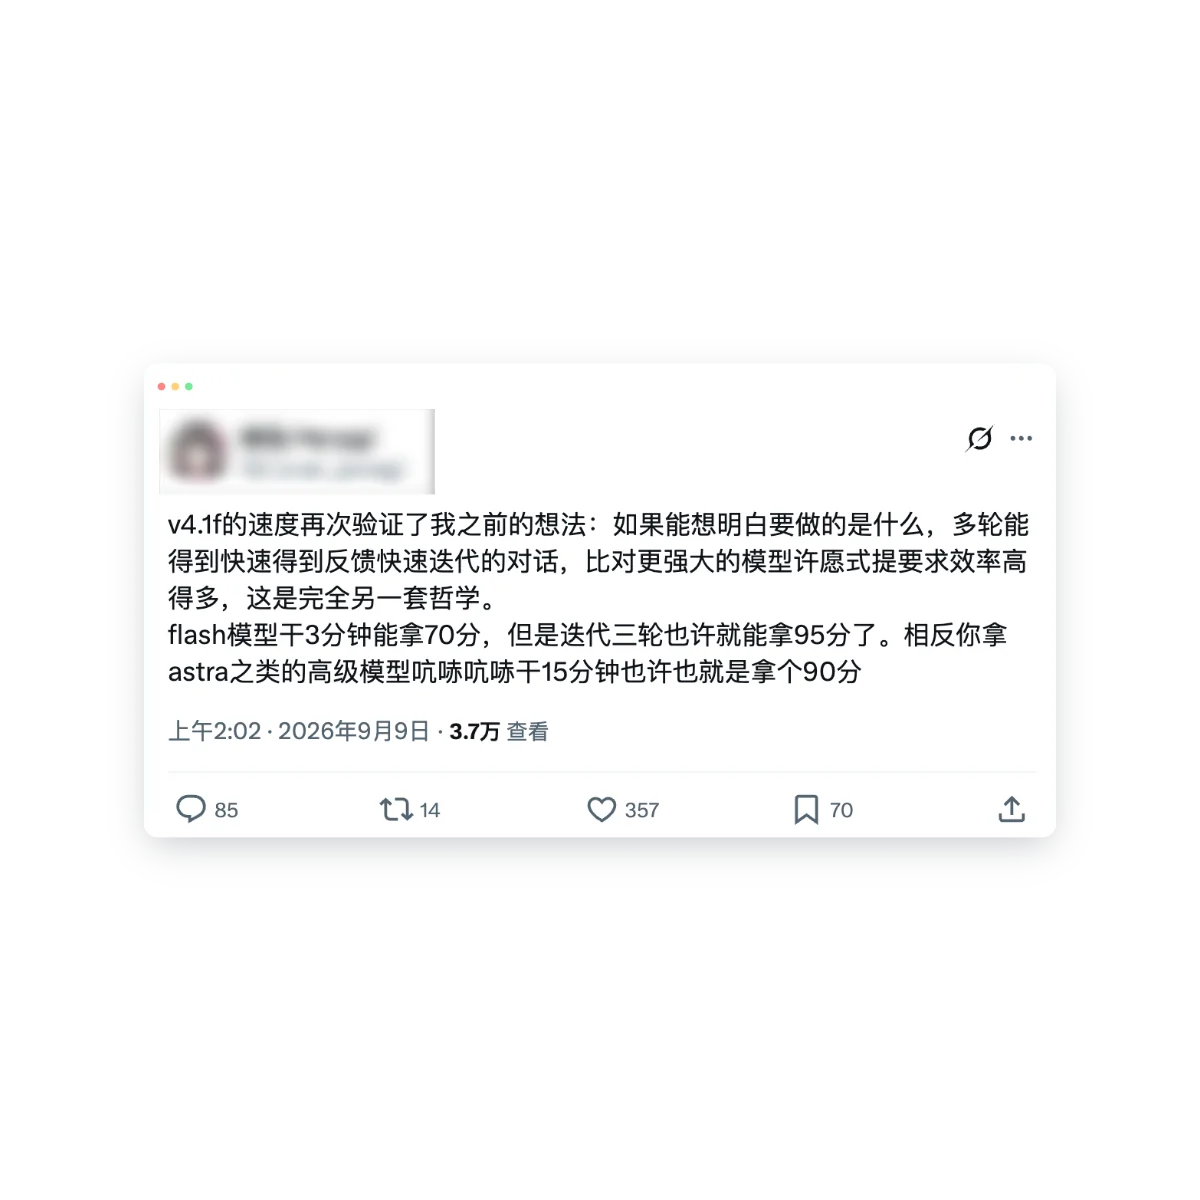
说速度快我是相信的,GLM-5.2 就非常快,常常 Opus 还在看代码,GLM-5.2 已经给 review 意见了。没道理后继的模型会变慢。再加上能读图这一点对我确实有用:前端 UI 问题,用说的、把报错复制进去,都比能直接看图的模型要麻烦。于是我等到 OpenCode 和 Devin 有这些新模型了,就把默认模型换了过去。然而最后的结果却让我大失所望……
踩了什么坑
先说读图。
我使用 Pi Coding Agent,模型是 deepseek-v4-flash-vision-exp。排查一个 webos app 的 UI 问题,模型自己去 TV 截图。
贴到第 5 张,API 直接回了 400:
1At most 4 image(s) may be provided in one prompt我一开始没反应过来,明明每次只发了一张。怎么会报错。升级了 Pi 版本没解决。换了 Opus 做相同试验。才发现,Agent 每轮请求都会把历史消息整个带上,前面贴过的图也在里面,累计超过 4 张就会被拒。这是从模型接口直接拒绝的,后面的请求全是 stopReason=error,这个 session 相当于报废了。
这是读图上限的问题。如果接口只能读 4 张,那还大力吹嘘读图能力,只能说是虚假广告。
后面只好在 AGENTS.md 里限制读取额度,导致别的正常模型也要遵守读图预算上限。
其次是发现这些模型经常跑很久。一点小问题,小需求,改半小时。
直到撞上 harness 给 reasoning 设的上限,被 Pi 和 Devin 直接掐掉。展开 thinking 一看,是大量推演。思考过程里都是狂磕一些细节。这种情况在两个 Flash 模型上最明显。它们想得快,想得多,但是解决相同问题,总是要多花几倍的时间。
「不要过度思考」能解决吗
一开始我是怀疑自己的。是不是 Prompt 没写好,没告诉它简洁一点?是不是任务给得太大,它在复杂逻辑里打转?
把一个需求拆小,给一个简单的任务,想得稍微久些,确实不会撞上限了,但是多来回几次,任务进入中段,它还是会撞上限,而撞了上限这个 session 就废了,基本无法再进行下去。
直接在 Prompt 提示,会如何? 比如:
- 「注意你的思考深度不要超出限制」
- 「不要过度思考」
完全没用,它照样一路想下去,想到 harness 上限退出。说明这个东西并不是 Prompt 能够优化的。
为什么大模型会 overthinking? 我让 GPT 去网上看看,有没有人已经遇到或者在试图解决相同的问题。
原来 Overthinking 已经是一个研究课题
我查了一下,这不只是你的体感。Overthinking 已经是大模型推理研究里的一个专门问题。
这里的 overthinking 不是回答太长、太啰嗦,而是模型已经掌握了足够的信息,已经找到可行方案,甚至已经得到正确答案之后,仍继续投入 reasoning compute。研究者关心的是:模型把推理资源花在了哪里,又为什么没有及时停下来。
Google DeepMind 的 TRACE 就在分析这件事。它没有只统计 reasoning token 的总量,而是把推理过程拆成一个个 sub-thought,观察模型为什么在每一步选择继续。里面有两种很典型的轨迹:
-
Explorer(过度探索)
已经有可行方案,模型却继续寻找其他路线:
1已经有一个可行方案
2→ 还有没有另一种可能?
3→ 验证第二种
4→ 又发现第三种可能
5→ 继续探索
搜索空间已经足够,但模型仍在扩张它。它把“还能继续想”误当成了“值得继续想”。
-
Late Landing(迟迟不落地)
模型很早就接近、甚至已经得到正确答案,却反复验证,不愿结束:
1得到答案
2→ 再确认一下
3→ 检查一个边界情况
4→ 怀疑前面的假设
5→ 重新验证
6→ 再确认
这属于 over-verification:发现答案的时间很早,真正停止的时间却很晚。
还有一类研究关注 reasoning 的边际收益。增加 reasoning token 并不保证准确率同步上升,它可能先带来正收益,随后接近零,最后变成负收益:
1额外 reasoning 的边际收益
2正收益 → 接近 0 → 负收益
模型有时本来已经答对了,继续推理后反而开始怀疑正确答案,最后把它改错。这可以称为 negative marginal reasoning utility。
所以需要区分三件事:
1解决问题的能力
2≠ 判断该投入多少推理的能力
3≠ 在已经足够时停止的能力
一个模型完全可能很聪明,却不擅长分配 reasoning,也不擅长停下来。Benchmark 通常更关心最后有没有答对;Agent harness 还要关心它用了多少 token、花了多少时间、调用了多少工具,以及能否在预算内结束。
至于「不要过度思考」为什么不一定有效,是因为自然语言 instruction 只能影响模型继续或停止的倾向,并不是确定性的资源控制器:
1Prompt:「不要过度思考」
2    ↓
3改变继续 / 停止的概率
4    ↓
5先确认一下 → 还有一种可能 → 再检查一下 → …
6    ↓
7Harness hard limit
8    ↓
9强制停止
Prompt 是 soft constraint;reasoning_tokens >= limit → terminate 才是 hard constraint。模型理解了“少想一点”,不等于它因此拥有了可靠的停止机制。
看到这里,我第一反应就是 Late Landing。两个 Flash 模型经常不是没有思路,而是一路确认、推翻、再确认,最后撞上 harness 上限。从表面上看,它很像已经具备落地条件,却始终没有作出停止决定。
这也解释了为什么那两句 prompt 没什么用。「不要过度思考」确实可能影响 reasoning 长度,但能影响不等于能保证。如果什么时候停止属于模型内部学出来的行为,只靠几句自然语言,很难把它变成严格的资源上限。
Flash 这个名字也容易让人误会。它更多是在说推理延迟、吞吐和价格,不保证 reasoning trajectory 短。每秒生成得快和总共生成得多完全可以同时成立:不是想得慢,而是很快地想太多。
于是我有了一个假设:问题可能出在模型对“这个任务值得投入多少 reasoning、什么时候应该停止”的判断上。两个 Flash 模型都出现类似现象,也让我怀疑模型学会了更积极地探索和自我纠错,却未必同比例地学会适时结束。
但这仍然只是一个假设。它到底想了多少,是在哪里停不下来的,和 GLM-5.2 差多少?这些 Agent 的 session 日志都存在本地,如何分析量化它们留下的踪迹?
量化探索 Overthinking 踪迹
session 日志
Pi 和 Devin 都会把 session 存在本地。我让 GLM-5.2 写了几个脚本,把 reasoning 内容从日志里抽出来,按模型分组统计。
先看哪些日志能读:
| 来源 | 日志路径 | 格式与字段 | reasoning 能读吗 |
|---|---|---|---|
| Pi | ~/.pi/agent/sessions/**/*.jsonl |
JSONL,content[].type === "thinking" |
能 |
| Devin | ~/.local/share/devin/cli/transcripts/*.json |
JSON,steps[].reasoning_content |
能(session 结束后才写入) |
| Copilot | ~/.copilot/session-state/*/events.jsonl |
JSONL,data.reasoningText |
能 |
| Codex | ~/.codex/sessions/**/*.jsonl |
JSONL | 不能(加密) |
| Grok | ~/.grok/sessions/**/chat_history.jsonl |
JSONL | 不能(字段是空的) |
Codex 和 Grok 排除掉了。
只统计带 thinking block 的 session。
先按我的使用体感分组,排除掉使用样本太少的模型:
| 分组 | 模型 | Session 数 |
|---|---|---|
| ✅正常组(共 153 个) | GLM-5.2 High | 68 |
| GPT-5.6 Sol | 56 | |
| GPT-5.6 Luna | 29 | |
| ❓问题组(共 85 个) | DeepSeek V4 Flash | 40 |
| GLM-5.3 Flash | 33 | |
| DeepSeek V4.1 Flash | 12 | |
| 🗑️样本不足,不参与比较(共 9 个) | Gemini 3.8 Flash | 3 |
| GPT-5.6 Terra | 2 | |
| Claude Opus 5 | 1 | |
| Qwen 3.7 Max | 1 | |
| ox-alpha-free | 1 | |
| GPT-5.4 | 1 |
thinking block 字符数
同样在 high effort 下,先看每个模型平均想了多少:
| 模型 | Session 数 | 平均最大块(字符) | 平均总思考字符 | 平均块数 |
|---|---|---|---|---|
| GPT-5.6 Sol | 56 | 513 | 4,418 | 25.0 |
| GPT-5.6 Luna | 29 | 1,362 | 11,440 | 79.6 |
| GLM-5.2 High | 68 | 7,117 | 35,510 | 26.4 |
| DeepSeek V4 Flash | 40 | 14,844 | 167,479 | 70.0 |
| GLM-5.3 Flash | 33 | 18,927 | 123,280 | 56.6 |
| DeepSeek V4.1 Flash | 12 | 29,795 | 221,134 | 67.1 |
GPT-5.6 Luna 平均最大块 1,362 字符,DeepSeek V4.1 Flash 是 29,795,差 22 倍。
GLM-5.2 在中间,比 GPT-5.6 多,比 Flash 少一截。
超标率
我给“超标”定了一个线。一个 session 满足下面任意一条就算:
- 有一个 thinking block 超过 12,000 字符
- thinking block 累计 80 个以上
- 累计思考字符 100,000 以上
| 模型 | Session 数 | 超标数 | 超标率 |
|---|---|---|---|
| GPT-5.6 Sol | 56 | 2 | 4% |
| GPT-5.6 Luna | 29 | 3 | 10% |
| GLM-5.2 High | 68 | 11 | 16% |
| GLM-5.3 Flash | 33 | 20 | 61% |
| DeepSeek V4 Flash | 40 | 25 | 62% |
| DeepSeek V4.1 Flash | 12 | 10 | 83% |
正常组在 4% 到 16%,三个 Flash 在 61% 到 83%,中间是空的。同一家的 GLM,从 5.2 的 16% 到 5.3 Flash 的 61%,差不多 4 倍。
这跟我的使用感受是对得上的。但超标率只说明它经常想得多,具体是怎么想多的呢?
数据的局限
- Devin 里 DeepSeek V4 / V4.1 Flash 最低只能选 high,low 和 medium 测不了。
- 都是真实使用的 session,每个模型做的任务难度不一样。累计阈值对长时间的正常 session 会误报。
两种典型的 Overthinking 形态
我们可以将 Overthinking 归纳为两种形态:
1形态 1: 纵向深挖(单块 10k~80k 字符,反复推演否定)
2形态 2: 横向铺开(单块看似正常,但几乎每次调用工具前都要想一段,总量堆得很大)
1. 纵向深挖(单块极端膨胀)
模型在一个思考块里陷入长达几万字符的自言自语,反复提出假设、推翻假设、重新论证边界条件。
典型表现:
- 正常模型的单块思考通常集中在几百字符,用来梳理调用工具的前置条件。
- 问题模型在单个块里动辄输出 20,000 ~ 70,000 字符,把一个简单的函数重命名当成登月工程来推导。
真实案例(GLM-5.3 Flash):
我让它查两个问题:快进时进度条会抖动,快进倍率没有生效。它一直没弄明白怎么用 adb 模拟长按,于是我在 3 分钟里连发了三条消息:
112:46:57  你还没研究出来怎么长按,读一下之间DS4.1的做法
212:48:26  你直接读session历史,有一个同样话题的pi session
312:49:54  session开头是 检查两个问题 1 播放界面下快进进度条会抖动……
「DS4.1」指的是之前一个用 DeepSeek V4.1 Flash 跑的同主题 session(「之间」笔误,应该是「之前」)。它去翻了那个 session,然后写出了整个 session 里最大的一个 thinking 块:59,740 字符。在这一块里,它先后把「DS4.1」猜成:
- DualShock 4 手柄,
.1也许是固件版本 - design spec 4.1
- AGENTS.md 里的第 4.1 条规则
0.5.1或PS4.1的笔误
中间它想过直接问我:
Actually, let me just ask… no wait
到了块的结尾,它还在研究手柄:
OR!!! Wait. DS4 as gamepad: D-pad on gamepads is often an AXIS (HAT_X/HAT_Y), not keys! …… OK, enough.
这个 session 一共 44 个 thinking 块,累计 247,665 字符。最后我自己上手测,发现快退也变成了快进,只能让它回退这部分代码,只保留数字抖动的修复。
2. 横向铺开(步步都在想,总量大爆炸)
这种形态更为隐蔽。单看每个思考块,大多只有几百到两三千字符,看起来很“克制”。但几乎每次调用工具之前都要先写一段,块数一多,累计思考量就很惊人。
真实案例(DS V4.1 Flash):
同一个 session 里,我先后提了两个需求:
| 需求 | thinking 块 | 累计字符 | 平均每块 | 最大块 | 工具调用 | 耗时 |
|---|---|---|---|---|---|---|
| 增加一个设定,让最近播放记录可以被清空 | 44 | 42,984 | 977 | 8,415 | 85 | 约 6 分钟 |
| 重新整理设定页面,让设定是单个栏位而不是双栏 | 39 | 71,666 | 1,837 | 9,430 | 63 | 约 13 分钟 |
两个需求合计 83 个块、114,650 字符、148 次工具调用,没有一个块碰到 12,000 字符的 critical 阈值,只看单块是抓不到的。第二个需求只是把双栏布局改成单栏,累计思考量却比上面那个 59,740 字符的单块还长。
翻开这些块,多数在想很小的事:
- 2,701 字符:纠结清空按钮旁边要不要显示「最近播放 N 条」,要不要用 plurals 资源,还顺带考虑了 RTL
- 1,363 字符:逐个列出改成单栏后哪些 import 可以删
- 786 字符:用
\bremember\b搜出remember出现了 3 次,再推理是哪 3 次 - 648 字符:仓库里没人用过
HorizontalDivider,不确定当前版本有没有,决定改用 1dp 高的Box当分割线 - 214 字符:
Oops! I accidentally replaced the material icons imports...,修自己上一步改错的 import
每一段单独看都说得过去,问题在于每一步都要写这么一段。
effort 同样是 high,含义却不一样
遇到 overthinking,最直接的想法是把 reasoning effort 调低。但我把四家官方文档里 effort 的定义放在一起看,发现同样叫 high,各家指的根本不是一回事:
| 可选档位 | 默认 | 文档怎么描述 | |
|---|---|---|---|
| OpenAI | none minimal low medium high xhigh max,视模型而定 |
medium |
high 用于难推理、复杂调试、深度规划;模型在各档内会自适应,简单任务用更少 token |
| Claude | low medium high xhigh max |
多数模型是 high |
high 是任务需要多少 token 就花多少;effort 是行为信号,不是严格的 token 预算 |
| DeepSeek | 实际只有 low high max |
high |
请求 medium 会映射成 high,请求 xhigh 也映射成 high |
| GLM | low high max |
max |
low 轻量推理,high 增强推理,max 深度推理 |
能直接从文档里看出来的有两点:
- 刻度不一样。 OpenAI 有 7 档,
high在中间偏上;DeepSeek 和 GLM 只有 3 档,high就是中间那档。Harness 下拉框里同一个high,背后是不同的刻度。 - 只有 OpenAI 和 Claude 把“按任务难度伸缩”写进了定义。 DeepSeek 和 GLM 的文档只描述了深度(轻量、增强、深度),我没看到类似的说法。
下面是我的猜测:
既然 effort 不是硬预算,high 到底想多少,只能是训练出来的行为:训练时让模型在每个档位下学会一个大致的长度分布。从文档的措辞看,OpenAI 和 Claude 至少把“同一档位下,简单任务少想、难任务多想”当成了训练目标。Flash 模型可能只学了“档位越高想得越深”这一个维度,对任务难度不敏感,于是一个很小的问题也按深度推理的长度去跑,这就是纵向深挖。这和前面那个假设对得上:问题出在“这个任务值得投入多少 reasoning”的判断上。
横向铺开可能和 interleaved thinking 有关。GLM 的文档写明默认开启 interleaved thinking,模型在每次工具调用之间都会思考。如果模型没学会“这一步很简单,不用想”,每次调用工具前都要交一段固定的“思考税”。上面那个案例里,几乎每轮工具调用前都有一个 thinking 块,正是这个样子。
再加上 Flash 的定位:它本来是用来又快又便宜地跑大量调用的轻量模型,现在却被放在了深度推理那一端的刻度上。
能不能在 Overthinking 发生的时候提醒我?
如果问题在模型本身,那从根上解决只有两条路:换模型,或者把 reasoning effort 降下来。
麻烦在于,很多时候没得降:
- Devin 里,DeepSeek V4 / V4.1 Flash 最低只能选 high
- GLM-5.3 官方去掉了
thinking.type: "disabled",thinking 一直开着,最低是 low。默认是reasoning_effort: "max"。官方 benchmark 里,max 档平均每个任务约 75K output tokens - DeepSeek 的 thinking 模式下,
temperature、presence_penalty、frequency_penalty都不生效 - OpenCode 也有人提 issue,要一个关闭 DeepSeek V4 thinking 的按钮。
等我觉得不对劲,它往往已经撞上 harness 上限,这个 session 就废了。我想要的是在撞上限之前,有个东西告诉我:这个 session 已经不正常了。
我先去找了 Pi 社区现成的插件:
| 插件 | 检测什么 | 为什么抓不到 overthinking |
|---|---|---|
pi-loop-police |
thinking 块里的连续重复(≥80 字符) | 抓的是卡死循环。而且 MAX_WINDOW 只有 4,000,超过 4,000 字符的块根本不看 |
pi-deadloop |
连续 4 轮回复 Jaccard 相似度 ≥85% | 也是循环检测 |
pi-behavior-monitors |
用另一个 LLM 给行为分类 | 不是规则检测,每次判断都要再调一次模型 |
pi-thinking-tail |
折叠显示长 thinking 块 | 只管显示,不检测也不提醒 |
它们都假设出问题就是在重复。但 Flash 的 overthinking 不重复,每个块都是新内容,只是太长、太多。
从上面的数据分布看,正常组和问题组差得很开,应该可以根据指标来判断 Overthinking 是否发生。
Next Action:做一个提醒工具 pi-overthink-warning
目标很直接:不替模型解决 overthinking,只判断当前 session 是不是明显偏离了历史上的正常分布,然后提醒我。
单块阈值
- 正常模型 session 的平均最大块是 3,936 字符,问题模型是 19,045,差 4.8 倍
- 正常模型的 thinking block,p95 是 2,608 字符,p99 是 6,672
阈值就卡在这几个位置上:
| 级别 | 阈值 | 含义 |
|---|---|---|
| warn | 5,000 字符 | 超过正常模型 p95(2,608) |
| alert | 8,000 字符 | 超过正常模型 p99(6,672) |
| critical | 12,000 字符 | 确认 overthinking |
在 5,000 字符,只有 1.56% 的正常块会触发,大约 64 个里 1 个。到 12,000,只有 0.37%,误判概率已经很低很低。
累计阈值
对应第二种形态:
- 正常模型平均每个 session 25 到 35 个块,5k 到 35k 字符
- 问题模型平均每个 session 58 到 88 个块,129k 到 281k 字符
| 级别 | 块数 | 总字符 |
|---|---|---|
| warn | 50 以上 | 或 50,000 以上 |
| alert | 80 以上 | 或 100,000 以上 |
50 块 / 50k 字符是正常模型的上界,80 块 / 100k 字符已经进了问题模型的区间。任一指标到线就提醒。长时间的正常 session 也可能攒到这个量,所以累计这边只设 warn 和 alert,不设 critical。
插件化
几条原则:
- 只提醒,不干预。不往对话里插 prompt,不改 reasoning 内容,也不中断模型。
- 不阻塞。没有弹窗。warn 是黄色通知,alert 是黄色通知,critical 是红色通知。
- 只升不降。同一个 session 里记最高级别,不会每次工具调用都弹一遍。
- 文案建议 “Switch model”,其次是 “lower reasoning effort if available”。换模型放在前面,是因为很多模型根本没得降。
比如单块到 critical 时,提示是这样的:
1Thinking block {n} chars. Over 12000 confirmed overthinking.
2Switch model now or lower reasoning effort if available.
Devin 目前没法实时提醒。Devin 的 hook 只有 PreToolUse、PostToolUse、UserPromptSubmit、Stop、SessionStart、SessionEnd、PostCompaction,没有 reasoning 相关的事件。reasoning 内容要等 session 结束才写进 transcript,跑的过程中读不到。
安装和复现
仓库在这里:https://github.com/CheerChen/pi-overthink-warning
安装:
1pi install https://github.com/CheerChen/pi-overthink-warning分析脚本也放在同一个仓库里:
 1git clone https://github.com/cheerchen/pi-overthink-warning
 2cd pi-overthink-warning
 3
 4# 批量扫描所有 session,按模型分组
 5uv run scripts/batch_scan.py
 6
 7# 合并模型,计算超标率
 8uv run scripts/incident_rate.py
 9
10# 单个 session 的特征提取
11uv run scripts/analyze_overthinking.py "label" /path/to/session.jsonl
插件的局限
- 再重复一下,这个插件只是提示,不会阻止模型发生 overthinking。
- 每个模型做的任务难度不一样。对于正常使用的 session,也可能会误报。
最后
到这里我对 Flash 模型有了一些新的领悟。但是也付出了实际折腾的时间和精力。
整个折腾过程让我倍感疲惫,不是量化这些结果累,而是知道自己有这么多真实任务因为模型的缺陷而吃了 Overthinking 的苦头累。显然国产的大模型还有很多路要走。只追求快、便宜,没有质量,有什么实用意义呢?
而这些个只会吹的营销号,吃流量的时候能不能自己动动手,实际用一下再发言呢?总是上来就“瘫坐惊呼”,“重磅炸弹”,“斩杀线”,这种不负责任的话术,加上平台的大数据推给的都是不回头的过客,让数字时代的发言都接二连三地“合并同类项”成了一种只为搏眼球的荒唐行径。
参考
- Do LLMs Really Need 10+ Thoughts for “Find the Time 1000 Days Later”? Towards Structural Understanding of LLM Overthinking
- Do NOT Think That Much for 2+3=? On the Overthinking of o1-Like LLMs
- Inverse Scaling in Test-Time Compute
- Thinking Mode | DeepSeek API Docs
- GLM-5.3 - Z.AI Developer Document
- [FEATURE]:Deepseek-V4 need a “disable thinking” button · anomalyco/opencode#24610
 Hi,我是 CheerChen。